私のHyperstrataのグラフ描画について
Hyperstrata を提唱した記事で[1]AI コーディングエージェントを使えば記事同士のネットワークのグラフなんて簡単に描画できると言った。 これは適当なグラフで良いなら簡単に描画できるのはそうかもしれないが、良い感じにバランス良い見た目のグラフを作るということを目指すと案外簡単ではないかもしれないことに気が付きつつある。
前回は、私の Hyperstrata にシリーズの概念も付け加えた[2]ので長い接続なども生まれやすくなっている。 これも考慮した上で、現在のグラフ描画がどのようになっているかを説明しよう。
現時点でのグラフのアルゴリズム
現時点では、前後のリンク関係のあるグラフを以下の論文をベースに AI に実装してもらった実装で組み立てている。

この論文は以下の論文の拡張で、グラフ全体の横幅の制限を加えられるようにしたものだ。

https://www.graphviz.org/documentation/TSE93.pdf
また、以下の Brandes–Köpf 法の論文も参照しているようだ。
この Brandes–Köpf 法の Erratum の paper は shivaduke さん[3]に教えてもらった。
パフォーマンスに関しては、現状の程度の記事数ではグラフのビルド時間は気にならない程度ではある。
graph.json という json ファイルにグラフのドットの座標や線の情報、そして記事タイトルなどなど様々な情報が入っているが、あくまでサブ的な描画に使われるものなので Web サイトが操作可能になるまでに必要な情報ではない。 そこで graph.json はレンダリングをブロックせずに非同期で取得して遅延して表示するようにもしている。
デカいグラフを描画するとなるとフロントエンド側で色々調整は必要かもしれないが、今や Claude Code が Chrome と接続したり、Node の Lighthouse を与えるとそのスコアを見ながら最適化してくれるので楽ではある。
過去のグラフの様子
グラフの描画のアルゴリズムは色々手を加えて調整をし続けており、最初のころから比べるとだいぶ違うものになった。 最初のころから順にグラフのスクショを貼って変化を見ていこうと思う。
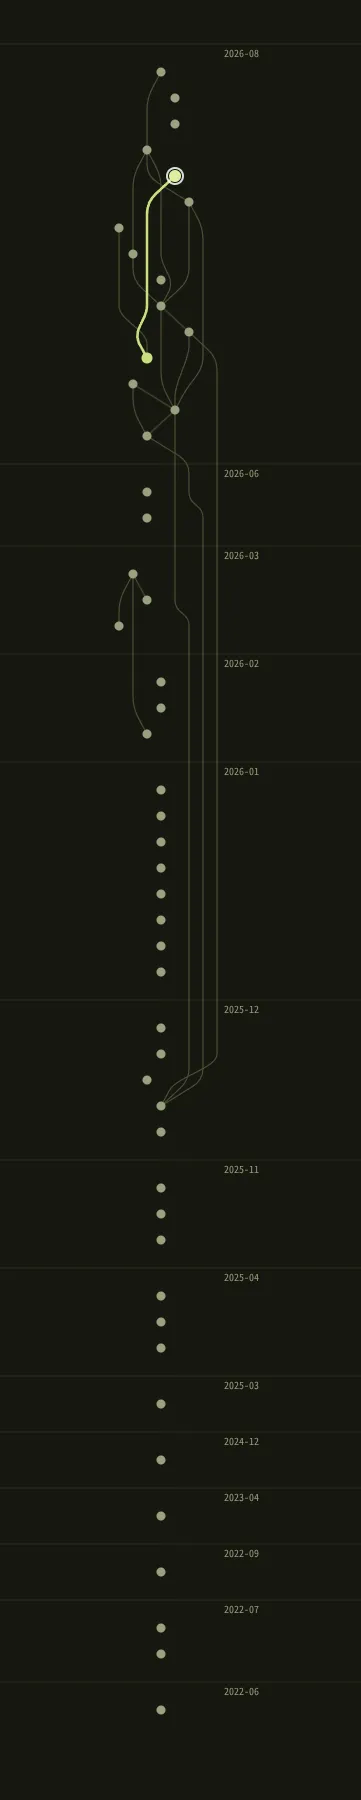 最初の頃はこんな感じだった。
並び替えを交差の数が少なくなったり中央寄りになるようにというエネルギーを与えた上で最適化問題として色々探索して解かせていたが、中央に寄せる力が強すぎた。
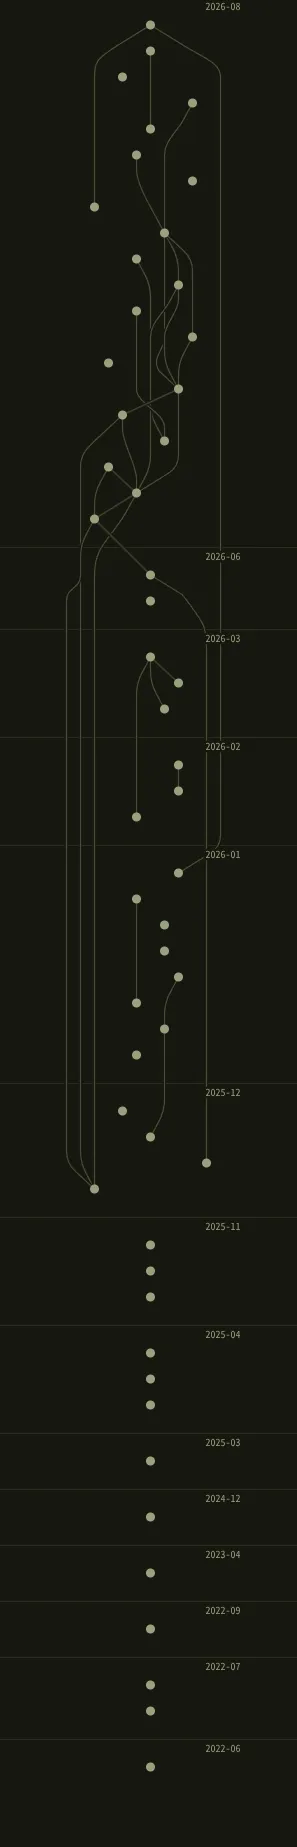 もう少し左右にドットがバラける様にエネルギーを調整したところ。
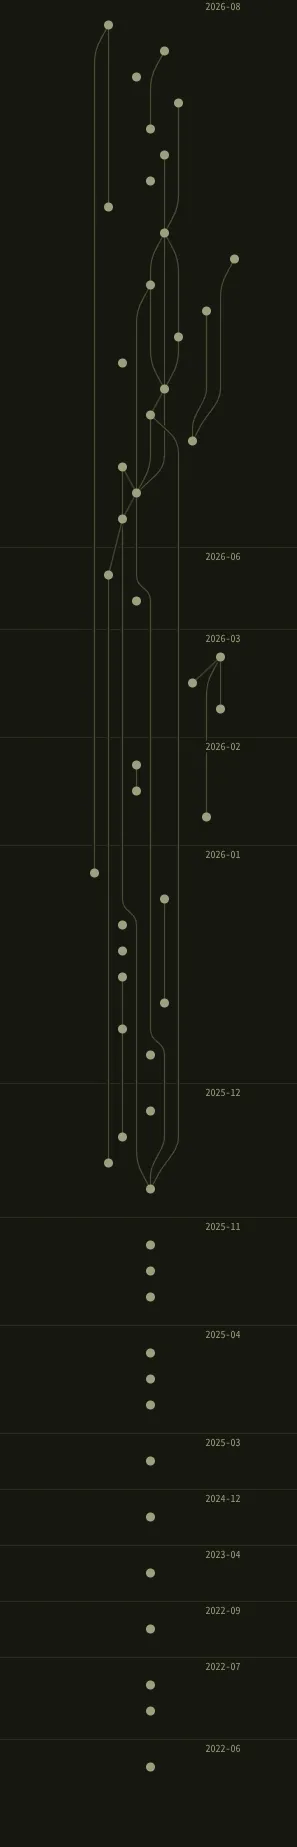 Brandes–Köpf 法の erratum を AI に読ませて作らせたもの。
ただ、実は正しく実装できていなくてlコーディングエージェントが勝手に行ったアレンジが加わっていたらしい。
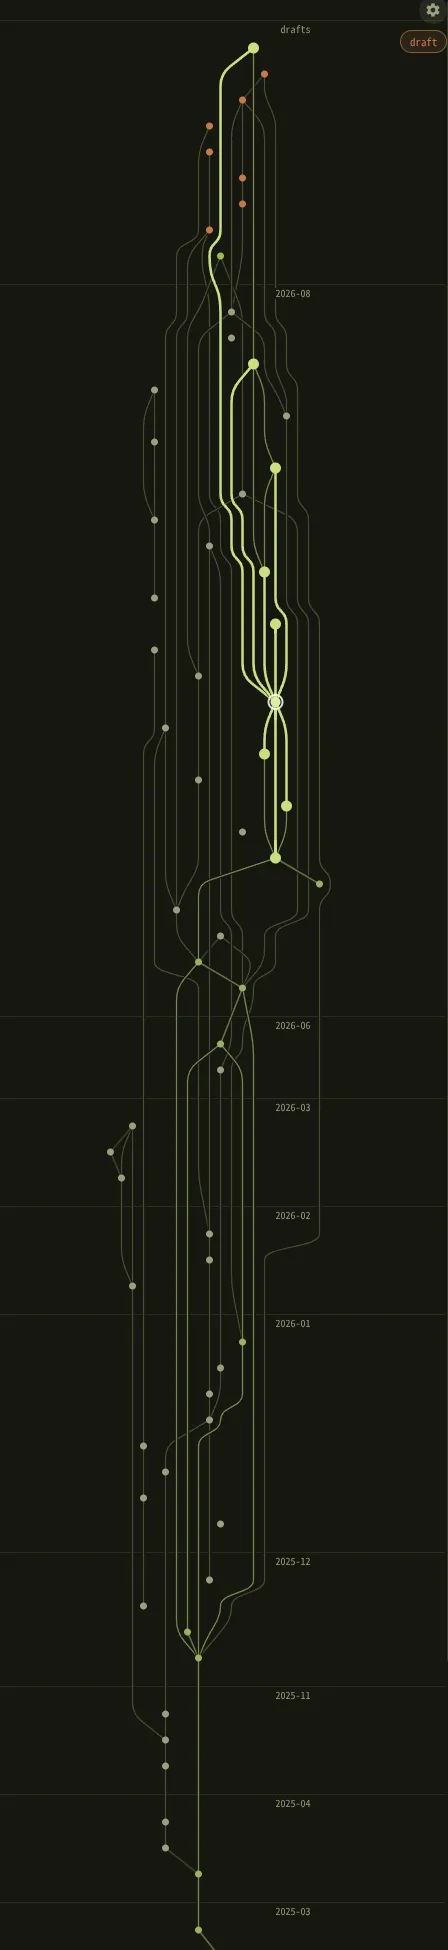 上記のまま記事数が増えると線がぎっちり詰まっている感じが微妙に感じられてきた。
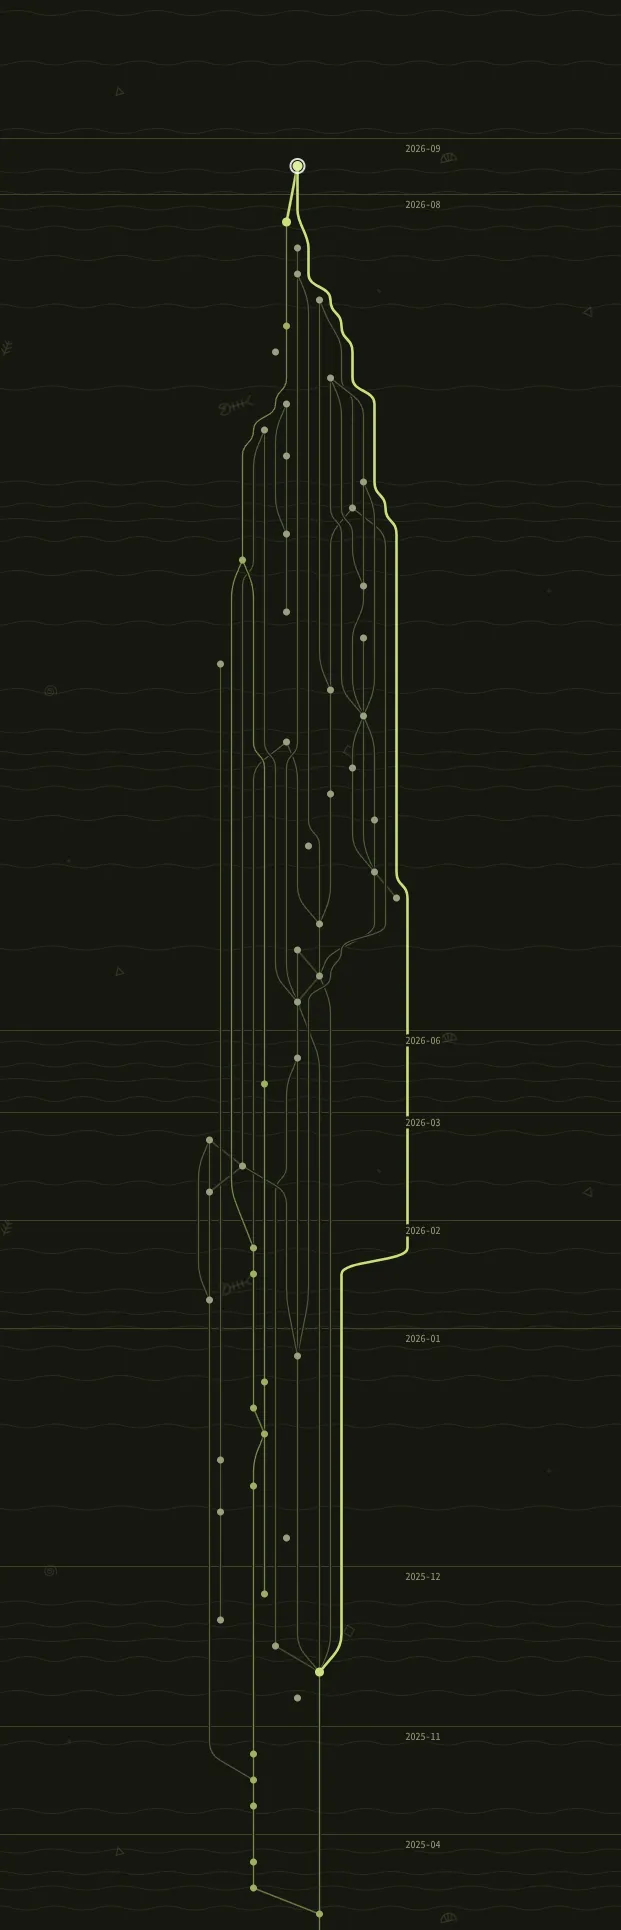 遊び心で背景に魚の骨の化石とかアンモナイトの化石っぽいのとか、跡は地層っぽい線を追加してみた。
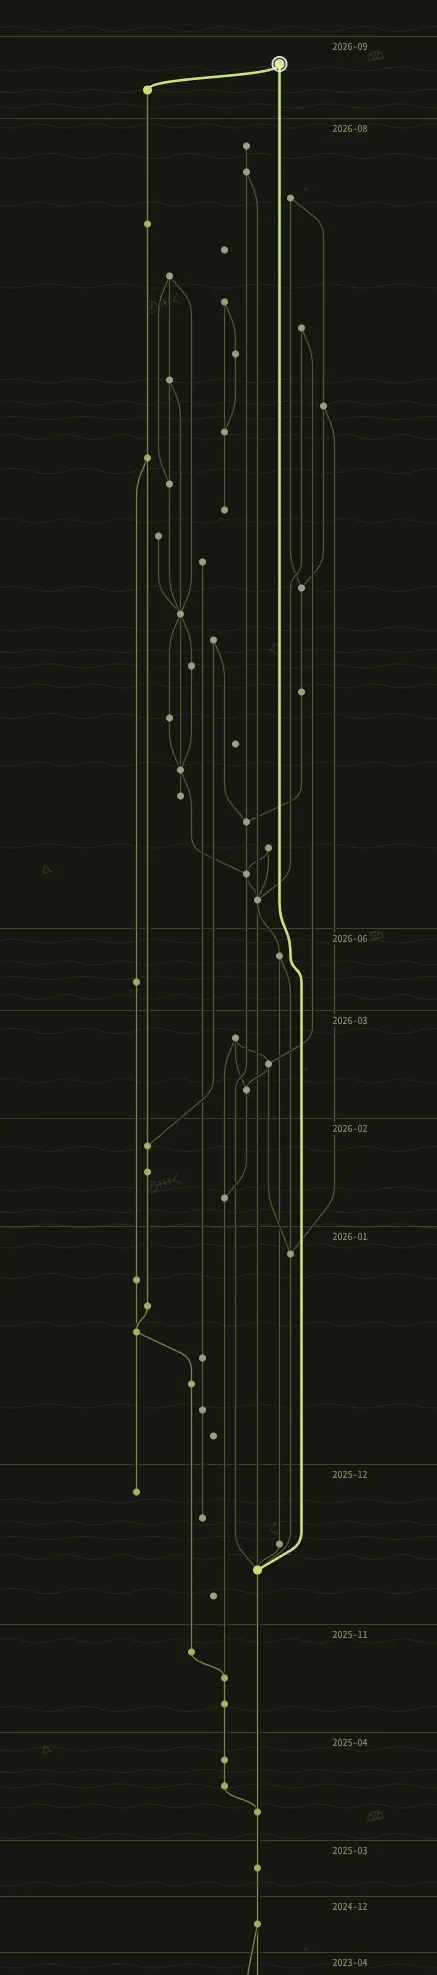 そして改めて論文の実装を正しくやり直してもらった上で、一応現在のアルゴリズムではこんな感じではある。
グラフ描画のアルゴリズムを色々調べて実装させて描画結果を見て比較して良さげなのを選ぶというのを何度かやっているが、今後もまだまだグラフの構築方法を変えるかもしれない。 ひとまず現状はこうなっているということで、何かの参考になれば。。。